

Les entreprises qui déploient des systèmes d’intelligence artificielle doivent prendre en compte non seulement où sont stockées les informations sensibles, mais aussi ce qu’il advient de ces données lorsqu’elles sont utilisées. Le confidential computing vise à protéger les données pendant leur traitement, en venant compléter les contrôles qui protègent les informations au repos et en transit.
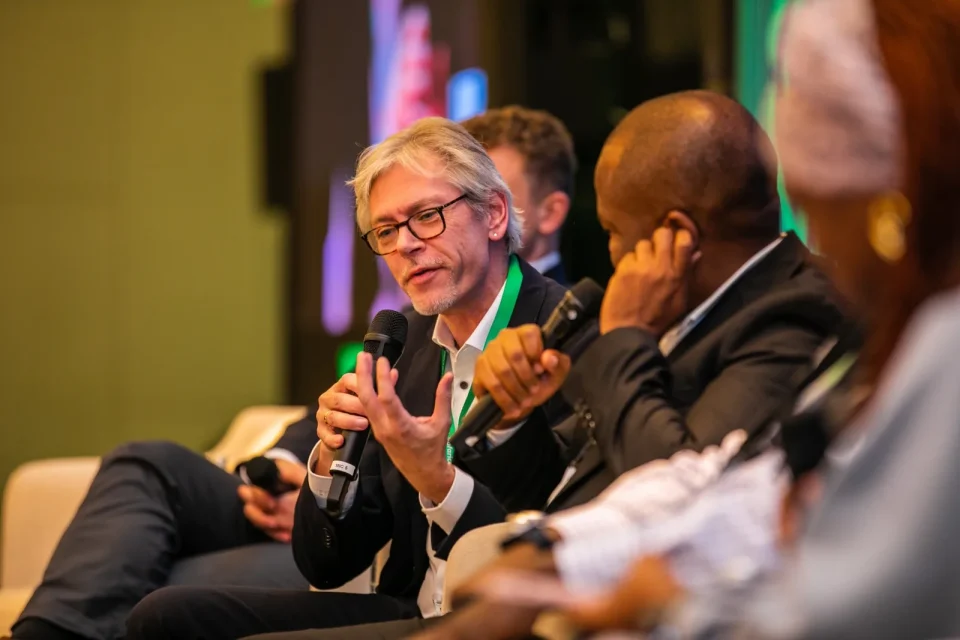
L’enjeu a été évoqué lors d’une table ronde au Safaricom Cybersecurity Summit 2026 à Nairobi. Dr Markus Leberecht, principal engineer chez Intel, a mis en garde : maintenir des systèmes d’IA sur site n’élimine pas automatiquement les menaces internes ni ne garantit une protection suffisante des informations sensibles. Le lieu physique d’un serveur compte, mais la manière dont les données sont accédées et traitées façonne aussi le niveau de risque.
Confidential computing : combler l’écart entre stockage et traitement
La protection traditionnelle des données se concentre souvent sur deux états : le chiffrement au repos pour les informations stockées et le chiffrement en transit pour les données en mouvement. Mais lorsqu’une application doit traiter ces données, elles doivent être utilisées sous une forme exploitable par le calcul, et cette étape de traitement crée une zone de risque, en particulier pour des dossiers d’entreprise confidentiels, des informations personnelles ou des modèles sensibles.
Les systèmes d’IA ajoutent de la complexité en traitant de grands volumes de données et en se connectant à plusieurs services. Une organisation doit savoir quelles données sont utilisées, quels composants peuvent y accéder et ce qui se passe quand une charge de travail s’exécute sur une infrastructure gérée par un tiers.
Comment fonctionne la protection pendant le traitement
Le confidential computing s’appuie sur des mécanismes de sécurité matériels pour créer des environnements protégés de traitement, souvent appelés trusted execution environments. Selon la plateforme et l’implémentation, ces environnements peuvent limiter l’accès aux données et au code pendant l’exécution d’une charge de travail, y compris vis-à-vis de certaines couches logicielles privilégiées.
Cette protection est conçue pour compléter d’autres garde-fous plutôt que les remplacer : chiffrement au repos et en transit, gestion des identités, principe du moindre privilège, surveillance et conception applicative restent nécessaires. Le niveau réel de protection dépend du matériel, de la pile logicielle, de la configuration et du modèle de menace retenu.
Pourquoi l’hébergement local ne suffit pas
Conserver modèles et données sur site donne un contrôle plus direct sur l’infrastructure et le lieu de stockage, mais n’empêche pas un initié autorisé d’abuser de ses accès, ne bloque pas un logiciel compromis et n’assure pas que chaque application connectée respecte les règles de l’organisation. Le même raisonnement vaut pour le cloud : les services cloud offrent des contrôles et une infrastructure gérée, mais les clients doivent comprendre leurs responsabilités, configurer les accès et vérifier le traitement des données.
La classification des données reste un point de départ important : identifier les enregistrements sensibles, déterminer quelles charges de travail peuvent les traiter et définir des règles d’accès. Sur cette base, une organisation peut évaluer si le confidential computing, des contrôles d’identité renforcés, l’isolation des charges de travail ou d’autres mesures répondent aux risques identifiés.
Comment évaluer la technologie
Les équipes sécurité et techniques doivent partir d’un cas d’usage défini plutôt que de choisir une technologie parce qu’elle est liée à l’IA. Elles doivent identifier les actifs à protéger, les parties ou composants logiciels qu’elles n’approuvent pas totalement, les exigences de performance et les conséquences d’une défaillance de sécurité.
Il faut aussi examiner comment les charges de travail protégées sont déployées, surveillées, mises à jour et récupérées. Les mesures techniques sont plus efficaces lorsqu’elles s’inscrivent dans un système plus large de gouvernance, de contrôle d’accès et de réponse aux incidents.
Au fur et à mesure que des informations plus sensibles sont intégrées aux flux de travail IA, la protection des données pendant leur traitement mérite une place dans la planification de la sécurité. Le confidential computing constitue un outil pour cette tâche, dont l’efficacité dépend de sa mise en œuvre et de son intégration avec le reste des contrôles de l’organisation.
